
关于Python
引言
Python语言名字的来源和蟒蛇(python)没有直接关系,而是来自英国著名喜剧团体 Monty Python(巨蟒剧团),Python 之父 Guido van Rossum 是 Monty Python 的粉丝
常用命令选项
python [选项] [脚本文件]
- -c "command":快速执行一段python代码
- -m 模块名:通过模块导入机制运行模块,可以将模块作为主程序执行
- -i 脚本名:执行脚本后进入交互式解释器
- -u 禁用标准/错误输出的缓冲,常用于脚本的输出被重定向到管道、文件的情况,如:python -u test.py > output.txt。默认情况下,这些输出会进入缓冲区,并在缓冲区积累一段时间后才真正写入文件(以块形式缓冲输出),如果此时在tail实时监听输出,可能导致看到输出不及时,-u可以使得解释器更积极输出信息
- -O 启用基本优化,会进行以下
- 移除所有 assert 语句,不再执行断言语句
- 将__debug__ 置为 False,编译器会直接移除字节码中 if __debug__: 内部的代码
- 将字节码缓存在不同目录/文件名下,文件名后缀为.opt-1.pyc,表示优化级别为1
- -OO:具备-O所有行为,并额外移除所有文档字符串(docstring)
- -v 查看版本
- -h 帮助
交互模式
类Unix系统中,Python解释器默认安装在/usr/local/bin/目录下,在python shell中:
- 主提示符为>>>
- 次提示符为...
- 退出解释器:在主提示符中,输入EOF文件结束符(Unix中为Control-D,Windows中为Control-Z)并回车,或使用python命令quit(),该方法退出状态码为 0
- 交互模式下,上次输出的表达式会赋给变量_,如:num + _会捕获上次运算的结果并加到num变量中
- 可以在OS环境变量中添加 PYTHONSTARTUP环境变量,让其指向一个文件,每次交互式 Python shell 启动时,会首先执行其中的代码,类似于 Unix shell 的 .profile 功能
Python 3.13+ 支持
- 彩色Python shell
- 可以直接通过 exit和quit命令提出 shell
- F1 相当于执行 help ,进入帮助页面,可以直接输入命令、模块获得帮助
- F2 打开历史命令,相当于Linux中的 history
- F3 进入粘贴模式,方便粘贴大段代码,避免逐行执行导致的缩进/语法错误
脚本文件
默认情况下,Python源码文件的编码是UTF-8,如果要修改文件的编码方式,则需要进行编码声明:
- 在脚本文件第一行添加以下特殊注释# -*- coding: 编码方式 -*-
- 如果脚本第一行为UNIX shebang,则编码声明要写在文件的第二行#!/usr/bin/env python3 # -*- coding: 编码方式 -*-
缩进
- Python 使用缩进表示语句块的层级结构(而非大多数语言使用的大括号{ }),缩进属于 Python 语法的一部分,这是Python的一大特色
- Python语句(逻辑行)开头的空格和制表符用于确定该行的缩进层级。具有相同缩进层级的语句属于同一个语句块。源代码中应保持缩进方式一致,文档建议不要混用制表符(Tab)和空格。通常建议统一使用4 个空格表示一级缩进,并交由编辑器自动处理缩进
传入参数
解释器读取命令行参数,把脚本名与其他参数转化为字符串列表存到sys 模块的argv 变量里,使用方法:
- 导入模块import sys
- 通过argv[索引值]访问元素,未给定输入参数时,sys.argv[0] 是空字符串
- 文档使用/和*标识函数的参数应该以什么方式传入:
- /代表 / 前的参数为位置参数,如:def foo(a, b, /, c)中,可以通过foo(1, 2, c=3)和foo(1, 2, 3)传参,而foo(a=1, b=2, c=3)是错误的
- *代表 * 后面的参数只能按关键字传参,如:def bar(a, *, b)可以通过bar(1, b=2)调用,但bar(1, 2)是错误的
数据模型
对象、值与类型
Python将各种类型的数据抽象为了对象(Object),Python程序中的所有数据都是由对象或对象间关系来表示的,每个对象都有三个基本属性:标识号(identity)、类型(type)和值(value)。Python中的对象被创建后,其标识号在其生命周期内不会改变,标识号在CPython中可以理解为该对象在内存中的地址
- 可以使用is运算符比较两个对象的标识号是否相同
- id()函数会返回代表该对象标识号的整数
- type()函数会返回该对象的类型,与编号一样,一个对象的类型也是不可改变的
a is b # 将返回True
id(a) #输出140732635804456
id(b) #同样输出140732635804456
内置类型
Python中的数据类型可以从“对象支持什么操作”这一数据模型(data model)角度进行分类,相同类型的数据通常支持一组通用的公共操作(如:切片访问)
- None:该类型只有None一种取值,在许多情况下它被用来表示空值,如:未显式指明返回值的函数将返回 None,其逻辑值为假
- 数字类型(numbers):用于表示数值,并支持相应的算术运算。Python 内置的主要数字类型包括整数(int,其中Boolean类型是int的子类)、浮点数(float)和复数(complex)
- 序列(Sequence):有限、有序的对象集,可以通过整数索引访问元素。序列通常支持索引、切片、长度计算、成员测试、拼接和重复等通用操作。序列可以进一步分为
- 可变序列(Mutable Sequence):可变序列在被创建后仍可被改变,包括通过下标、切片赋值或通过del语句删除,列表(list)、字节数组(bytearray)属于该类型
- 不可变序列(Immutable Sequence):不可变序列类型的对象一旦创建就不能再改变,但如果对象包含对其他对象的引用,其中的可变对象是可以改变的(不可变序列对象可以包含可变对象,),字符串(str)、字节串(bytes)、元组(tuple)属于该类型
- 集合(set):表示一组无序且不重复的元素,它们不能通过下标来索引。但是它们可被迭代,也可用内置函数 len() 返回集合长度。集合常见的用处是快速成员检测,去除序列中的重复项,以及进行交、并、差和对称差等数学运算,Python目前有两种内生集合类型:
- 集合(set):属于可变集合(Mutable Set)。集合中的元素必须是可哈希的(hashable),可以添加和删除元素
- 冻结集合(frozenset):属于不可变集合(Immutable Set),创建后不能修改,因此本身可以作为字典的键或其他集合的元素
- 映射(Mapping):表示键(key)到值(value)的对应关系,与序列通过整数位置访问元素不同,映射通过键访问值。映射类型可以被赋值、通过del语句删除、len()函数返回长度,Python目前只有一种内生映射类型:
- 字典(dict,全称dictionary):Python最常用的键值映射结构。字典是可变的,每个键映射到一个值;键必须是可哈希对象
数据类型分类
根据数据类型的其他特性,它们还能被分为
- 可变(Mutable)类型:其Python对象创建后可以修改其内部值或内容的对象,修改不会创建新的对象,这样的类型有:list、set、dict、bytearray
- 不可变(Immutable)类型:不可变对象在创建后其值不能被修改,如果需要得到不同的值,只能创建或取得另一个对象,再让名称重新绑定到该对象,这些类型包括: int、float、complex、bool、str、tuple、range、bytes、frozenset
- 可迭代对象(Iterable):提供迭代器,从而能被for等语句遍历访问,它们包括:str、list、tuple、range、set、frozenset、dict、bytes、bytearray
- 可哈希对象(Hashable):够产生稳定的哈希值,并可以作为字典的键或集合中的元素,通过来说,不可变对象通常适合成为哈希对象,它们包括:int、float、complex、bool、str、tuple(元素也必须全部可哈希)、bytes、frozenset(元素也必须全部可哈希)
可变对象与深拷贝、浅拷贝
数值
Python中数值共有三种类型:整数、浮点数和复数,它们可由 int、float、complex类构造函数构造
int整型
- 字面量:整数字面量的长度没有限制,仅受可用内存的存储能力限制,Python会根据数值大小动态分配存储位数,不再有静态语言的限制
- 可以使用下划线_对数字进行分组以增强可读性,如:100_000_000_000与100000000000是一样的,但下划线只能出现在数字之间,如:_123不是有效字面量
- 可以使用前缀0b、0o、0x将整数指定为二进制、八进制或十六进制(A-F大小写不敏感),同时也可以在前缀之后添加下划线,如:0x_1f 是正确的,0_x1f 则是错误的
- 非零十进制数中不允许有前导零,如:0123不是有效的字面量
- 构造器:int(x=0, base=10)
- 传入空参数时 int() 会创建0
- x 可为整数、浮点数、字符串:
- 如果是浮点数,会截断整数部分而不会四舍五入,如:int(1.999) 返回 1
- 如果是字符串,字符串不能带有如何非数值类型的字符(可以包含正负号、空白字符、用于分组的_),否则抛出ValueError,因此推荐先 str.isdigit() 判断是否包含非数值字符 或 try/except
- base :在x为字符串时添加,用于指定进制(2-36) ,此时字符串中允许带有A-F等多进制使用的字符,如:int("0xFF", 16)
布尔值
- 布尔值只包括True和False两种值(大小写需要严格遵循该写法,true、TRUE等都是错误写法)
- python中 bool 是 int 的子类,且True == 1,False == 0,因此有:True + True =2 ; 10 * False = 0
- 构造器:bool(),传入:0、None、空字符串、空数据结构(空列表、空字典、空集合)等都返回False,其他为True
- Python中False, None, 0, 0.0, "", [], (), {}, set()以及各种空容器都视为假,其他对象通常被视为真;对象可以通过__bool__()自定义其真值
float浮点数
- 字面量:
- 浮点数允许前导0,如:077.010和77.01都是合法的,表示同一值
- 整数部分或小数部分可以为空,但不能同时为空,如:10.表示10.0;.001表示0.001
- 可以使用e或E表示10的x次冥,如:1.0e3表示1000
- 构造器:float()
- 传入空参数时 float() 会创建0.0
- 传入字符串时,字符串中只能包含正负号、数字、空白字符、e、分组符_,以及以下特殊值
- float 支持三个特殊值:inf(正无穷,或用全写Infinity)、-inf(负无穷)、nan(not a number,无效数值,等同于JS的NaN)
- 在判断一个float是否为nan时,应该使用math 模块中的 math.isinf(float),float('nan') == float("nan") 符号判断会返回 False
复数
- python使用j(或大写J)作为虚数单位而非 i,如:3+4.2j
- j 前面的数字部分与浮点字面量的语法规则相同,如:3.14_15_93j也是合法表示
NoneType
None是 NoneType 类型唯一的实例,常用于表示没有值、缺省值或不存在的结果等,给 None 赋值是非法的并会引发 SyntaxError。
序列
序列是有限、有序的对象集,Python提供丰富的序列类型:
- 容器序列:存放的是容器所包含对象的引用,它们能存放不同类型的数据:list (列表,可变序列)、tuple (元组,不可变序列)、collections.deque(collections模块提供的双向链表)
- 扁平序列:只能存放一种类型的数据:range 对象、str(字符串)、bytes(二进制数据)、bytearray、memoryview、array.array
- 只整理常用的类型
序列的操作
通用操作
通用运算:
- in/not in:判断某项是否存在于序列中,如:x in s,如果s中的某项等于x则结果为True,否则为 False,x not in s 反之
- s + t:s 与 t 相拼接
t1=(1,2,3)
t2=('a','b','c')
t1+t2 输出 (1, 2, 3, 'a', 'b', 'c')
# 即便t1,t2是元组,内容无法修改,但它们可以通过该方式拼接出新的元组 - s * n:相当于 s 与自身进行 n 次拼接
t1 *3 输出(1, 2, 3, 1, 2, 3, 1, 2, 3) - 索引访问:以s[ i ]形式访问序列
- 对于不可变序列,只能通过 s[i] 获得该元素,但不能修改;对于可变序列,可通过 s[i] = x 修改元素
- 支持负数索引(从-1开始,因为-0 = 0,它们都指向序列的第一个元素),如对于字符串:word = 'python',word[-1] 为 'n'
- len(s):返回序列长度
- min(s):返回 s 的最小项
- max(s):返回 s 的最大项
- 切片(slice)操作:以s[i:j]方式获得/修改子序列,子序列不包含结束索引 j 指向的元素(左闭右开[i,j)形式),比如:word = 'python' 切片word[0:2] 输出 'py'。额外有:
- 省略开始索引时,默认从 0 开始:word[:2] 输出为 'py'(不含2)
- 省略结束索引时,默认到字符串的结尾:word[4:] 输出为 'on'(含4)
- 负数索引类似:word[-2:] 输出 'on'(含-2)
- s[:i] + s[i:]总是等于s:word[:4] + word[4:] 输出 'python'
- 索引越界会报错:word[100]报错IndexError: string index out of range
- 但切片会自动处理越界:word[4:42] 输出 'on'
- 切片可以理解为如下排列形式,所切索引位于字符之间:loading
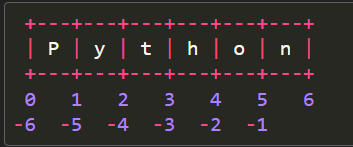
- s[start:stop:step]:带步长的切片,表示序列s 从 start 到 stop 步长为 step 的切片,s[::-1]可以反转字符串,如:word = 'python';word[::-1]将输出'nohtyp'。步长切片的执行逻辑为:
- 如果 step > 0,则默认 star = 0,stop = len(s),遍历取值
- 如果 step < 0,则默认 star = len(s)-1,stop = -len(s)-1,遍历取值
s=[0,1,2,3,4,5]
s[:4:2]     # [0, 2]
s[:4:-1]    # [5],start=5,stop=4(不包含)
通用方法:
- sequence.count(value):返回value在序列中出现的总次数
- sequence.index(value[, start[, stop]]):返回value在sequence中首次出现所在的索引号,如果value不存在于sequence中则会引发ValueError。可以指定start 或 stop 参数来对该部分索引进行高效搜索
可变序列类型支持
可变序列类型支持的运算:
- 通过索引、切片修改序列:如:s[i] = x(将第i项修改为x);s[i:j] = t(将 s 从 i 到 j 的切片替换为可迭代对象 t 的内容);s[i:j:k] = t
- del 目标语句:删除元素:如:del list1(删除整个列表);del list[1](索引越界时报错);del list[2:4]等,注意del是一个语句,不是函数(print(del xx)是错误行为),没有返回值,语句del(lst[7])能运行是因为将(lst[7])视为了括号分组
- 修改原序列:如:s += t 、 s *= n
可变序列类型支持的方法 - sequence.append(value) 添加value到序列末尾
- sequence.clear()移除序列中的所有条目
- sequence.copy()创建 sequence 的浅拷贝,等价于 sequence[:]
- sequence.extend(iterable)使用 iterable 的内容扩展 sequence
- sequence.insert(index, value)向位置index插入value,等价于切片操作:sequence[index:index] = [value]
- sequence.pop(index=-1)从 sequence提取并移除位于index的条目并返回,不指定index时移除最后一个条目
- sequence.remove(value)根据值从 sequence 中移除满足一个条目,如果该值有多个则只移除第一个
- sequence.reverse()原地反转 sequence 的条目。此方法会在反转大尺寸序列时保持空间经济性,该方法返回值为 None
不可变序列类型支持
不可变序列类型特别支持的操作为:hash(),通过哈希可以将不可变序列映射为固定的键,方便存入字典等数据结构。可变类型由于内容可变,不适合通过哈希映射为键。
list列表
创建列表
class list ( iterable ) 列表是可变序列,支持存储多种复合数据类型,列表可以用以下方式创建:
- 使用方括号[]创建,如:squares = [1,2,'AA',3]
- 使用类型的构造器: list( iterable ),如果 iterable已经是一个列表,将创建并返回其副本,如:list('abc') 返回 ['a', 'b', 'c']
- 一些内置函数也会产生列表,比如:sorted()
列表操作
列表作为可变序列,支持 序列通用操作和可变序列支持的操作,以下是一些示例(来自Python官网的tutorial):
- 支持索引、切片访问/修改元素:squares = [1, 2, 'AA', 3];squares[-2:]输出 ['AA',3]
- 切片赋值可以修改列表大小,甚至清空列表:squares[:]=[] 此时squares将变为 []
- 列表支持+号合并:squares + [11,22] 输出 [1, 2, 'AA', 3, 11, 22]
- 列表元素是可被修改的(Mutable):squares[2]="BB"
- 列表可用list.append()添加单个或一组元素:squares.append([0,0]) 结果为 [1, 2, 'AA', 3, [0, 0]]
- 将列表赋值给一个变量时,该变量将引用列表,对变量的修改都将影响原有列表:list=[11,22,33] array = list # 引用赋值 array[1] = 'AA' list 将变为 [11,'AA',33]
- 通过len()函数返回长度
- 列表可以嵌套a = ['a', 'b', 'c'] n = [1, 2, 3] x = [a, n] # x 将变为 [['a', 'b', 'c'], [1, 2, 3]] # x[0]将输出['a', 'b', 'c'] # x[0][1]将输出 'b'
sort方法
list.sort(key=None, reverse=False)根据指定的key和reverse值进行排序,这是list额外提供的方法
- 该方法是原地排序(in-place),直接修改原列表,返回值为 None;功能与之相似的有内置函数 sorted(),sorted()会返回新列表,不改变原列表
- 排序时会使用<符号在各项间进行比较,以决定这些元素的先后顺序,如果任何比较操作失败,整个排序操作将失败。因此如果list中包含多个不同类型的元素(如:[1, 2, 'AA', 3]),直接执行list.sort()将抛出TypeError,因为不允许 int 和 str 比较大小,解决方法参考下文示例
- key是一个可选项,用于指定一个函数,排序时按照该函数的返回值进行比较,默认值为 None,常用的值有str.lower(忽略大小写)、len(按长度排序)、abs(按绝对值排序)或是自定义的 lambda 函数
- reverse是一个可选项,用于指定是否反转排序,默认值为 False,会升序排列,可选值还有 True
- Python还提供sorted()函数,该函数返回一个新列表,而不修改原列表,如:sorted(list2)
1. 默认情况下,sort会进行升序排序
nums = [3, 1, 4, 1, 5, 9, 2, 6]
nums.sort()  #nums变为[1, 1, 2, 3, 4, 5, 6, 9]
nums.sort(reverse=True) #nums变为[9, 6, 5, 4, 3, 2, 1, 1]
2. key 参数有以下用法
# 按字符串长度排序
words = ["apple", "banana", "kiwi", "cherry"]
words.sort(key=len) # ['kiwi', 'apple', 'banana', 'cherry']
# 按绝对值排序
nums = [-5, 3, -1, 4, -2]
nums.sort(key=abs)  # [-1, -2, 3, 4, -5]
# 忽略大小写排序
names = ["Bob", "alice", "Charlie", "david"]
names.sort(key=str.lower) # ['alice', 'Bob', 'Charlie', 'david']
3. 使用 lambda 表达式
# 按元组第二个元素排序
data = [(1, 3), (2, 1), (3, 2)]
data.sort(key=lambda x: x[1]) # [(2, 1), (3, 2), (1, 3)]
# 按字典某个字段排序
students = [
    {"name": "Tom", "age": 20},
    {"name": "Amy", "age": 18},
    {"name": "Bob", "age": 22},
]
students.sort(key=lambda s: s["age"])   # Amy(18), Tom(20), Bob(22)
4. 当list中是混合类型的元素时,需要通过key参数调整比较方式
lst = [1, 2, 'AA', 3]
lst.sort() #报错TypeError: '<' not supported between instances of 'str' and 'int'
# 将每个元素转成字符串再比较
lst.sort(key=str) #相当于按字典顺序比较['1','2','AA','3'],lst会排序为[1, 2, 3, 'AA']
# 先排序所有 int 再排序 str
lst.sort(key=lambda x: (type(x).__name__, x)) #[1, 2, 3, 'AA']
lambda表达式相当于
def key_func(x):
    return (type(x).__name__, x)
它会返回一个元组(type(x).__name__, x),将上述元素转换为:
[('int', 1),('int', 2),('str', 'AA'),('int', 3)]
将首先按元组的第一个元素比较,即所有的int将先排序,再排序str
tuple元组
创建元组
class tuple( iterable ) 元组属于不可变序列,一旦初始化就不能修改,可通过以下方式创建:
- 使用圆括号( )创建,如:创建空元组(),或创建有多个项的元组(a,b,c)
- 但真正决定生成元组的其实是逗号而不是圆括号,圆括号只是可选的(创建空元组,函数f((1,2,3))需要传入一个元组时除外)
- 因此定义一个只有1个元素的tuple时需要添加后缀逗号,如:a, 或 (a,);这是因为圆括号还用于运算表达式,如:result=(1+2)*1,因此如果是 tuple1=(1),则定义的是整数1,type(tuple1)返回的类型是int
- 使用内置的构造器tuple( iterable )创建元组:tuple('abc')将返回('a', 'b', 'c') 而 tuple([1, 2, 3]) 返回(1, 2, 3),不提供参数将创建空元组
元组操作
元组属于不可变序列,但如果其元素是对一个对象的引用,该对象的值是仍然可改变的
t = ('a', 'b', ['A', 'B'])
t[2][0] = 'X'
t[2][1] = 'Y'
print(t) #('a', 'b', ['X', 'Y']),元组t[2]依旧指向一个list对象,其指针指向对象并没有变,只是list内部值改变了
range对象
range (start,stop,step)该类型表示不可变的数字序列,常用于在 for 循环中循环指定的次数
- start,stop,step都必须是整数,它不像shell语言中的seq一样支持小数步长增长
- 如果省略 step 参数,则默认为 1。如果省略 start 参数,则默认为 0
- 执行时从 start 开始,每次加 step,直到达到或超过 stop 就停止,但永远不包含 stop 本身(左闭右开)
- 负数的step会降序:list(range(10,5,-1)) 生成 [10, 9, 8, 7, 6]
- range 对象只保存start, stop 和 step 值,因此无论最终产生的序列有多大,它都占用固定数量的内存,然后通过r[i] = start + step*i生成内容,因此它很适合用于运行时生成大量列表等
str字符串
Python中,字符串(string)将被作为文本序列进行处理,在Python 3中,字符串是以Unicode编码的,因此可以表示各种语言的文本。作为不可变序列,字符串支持序列的通用操作,还具有不可变序列所共有的特性。在此基础上,字符串类型还提供了大量针对文本处理的专用操作
创建字符串
- 使用构造器str( object ),如:str(123)返回'123';str(b'hello', encoding='utf-8')返回#'hello'(或b'hello'.decode());str([1, 2])返回'[1, 2]',如果需要的是'1,2'则需要",".join(str(x) for x in nums),构造器只返回 object 的 str 表示
- 字符串字面量声明可以使用"双引号"或'单引号'包裹,它们完全一样
- 使用三重引号"""三重双引号"""或'''三重单引号'''可以跨行输入文本,并且行结束符会被包含在字符串内(print输出时会保留文本的样式),如果不希望保留行结束符,可以在行尾使用延续字符\
- 如果文本本身包含单双引号,可用\转义,如:'doesn\'t',或者外部使用另一种引号:"doesn't"
- Python shell中,直接输出字符串字面量,其中的转义字符(如:\n)不会被解析,通过print()函数输出则会解析转义字符>>> s = "AA\nBB" >>> s # 不用 print(),特殊字符将包括在字符串中不转义 AA\nBB >>> print(s) # \n会被转义 AA BB
字符串前缀
Python 中字符串字面量允许带有不同的前缀(前缀不区分大小写):
- r(raw,原始字符串):转义序列不再会被转义,而是会原样输出,常用于正则表达式、文件路径等。如:s2 = r"C:\new\test"(避免\n被转义),该前缀可以与f、t、b前缀组合使用,不区分顺序(rf和fr一致)
- f(formatted,格式化字符串f-string):用于在字符串中直接嵌入表达式,如:print(f"{name} is {10+8} years old"),通过{ }引用变量/执行语句,如果要输出{}本身,只需要两个大括号嵌套即可
- t(template,模板字符串t-string):与f类似,但可以防止SQL 注入、HTML 转义等
- b(bytes字节串字面量):用于表示 bytes类型 的字节序列,而不是字符序列(str类型),前者常用于网络传输和文件存储。字节串字面量中的直接字符只能使用ASCII 字符,其他字符必须使用编码后的转义序列来表示。如:s = b"hello" ,如果需要将包含中文等非 ASCII 字符的 str 转换为 bytes,可以使用encode(),如:s = "你好".encode("utf-8"),print(s) # b'\xe4\xbd\xa0\xe5\xa5\xbd'
- u: 无效果,为兼容Python2而保留,不能与r同时出现
字符串拼接
- 多个相邻的字符串字面量会被自动合并,如:'py''thon'会被合并为'python',这允许跨行输入不需要延续字符或三重引号。该功能不能用于变量或表达式拼接,比如str1="AA",不允许:str1"new content">>> text = ('Put several strings within parentheses ' ... 'to have them joined together.') >>> text #字符串会被拼接 'Put several strings within parentheses to have them joined together.'
- 字符串也可以用+号拼接,且允许变量和表达式拼接,比如:3 * 'un' + 'ium',或者str1 + "new content"
常用字符串操作
以下是str对象中常用的方法,这些方法时应该通过str.形式在对象身上调用,字符串是不可变序列,因此它们都不会对原串进行修改,一般都是返回一个新的字符串
查找
- 检查某个字符串是否属于另一个串的一部分,应该使用in操作符,而不是以下方法
- find('子串'[,start[,end]] )获得子串 sub 出现时的最小索引,可以指定 start和end 指定查找范围(只有单个值将指定的是start),如果未找到返回-1。如:'spam, spam, spam'.find('sp', 5) 返回6,rfind()用法类似,它返回的该子串出现时的最高索引(倒查)
- index('子串'[,start[,end]]):类似于find(),但找不到子串时抛出错误,rindex()类似于rfind(),同样在找不到子串时抛出错误
- count('子串'[, start[, end]]):返回子串 sub 在 [start, end] 范围内出现的次数
- startswith('前缀'[, start[, end]]):如果字符串以指定前缀开头则返回True,前缀可以是多个想匹配元素组成的元组,如:'a tuple '.startswith(('at', 'a')),同样可以指定查找范围
- endswith('后缀'[, start[, end]]):如果字符串以指定后缀结束则返回True,同样支持通过元组提供多个匹配项,如:'a tuple of suffixes'.endswith(('at', 'es'))
分割与拼接
join(iterable):返回一个字符串,它是在可迭代对象iterable(列表,元组、集合、生成器、字典、文件对象)中的元素之间插入当前字符串拼接而成的。如:"==".join(['1','2','3']) 拼接出 '1==2==3',该方法的性能比+号拼接性能更好。但注意iterable中的元素必须全部是字符串,如果不是则需要提前处理
nums = [1, 2, 3] #需要将元素处理为字符串 # 转为字符串'1,2,3' ",".join(str(x) for x in nums) #通过 生成器 ",".join([str(x) for x in nums]) #通过 列表推导式split(sep=None, maxsplit=-1):分割字符串,返回一个列表,如:"a--b--c".split("--",3) #返回 ['a', 'b', 'c']
- sep:可选,指定分隔符,默认为 None,按照空白字符(空格、\t、\n、\r、\f、\v)分割
- maxsplit:可选,指定最大分割次数,默认为-1无限制,如果指定maxsplit,在达到最大分割次数后剩余部分会作为最后一个元素
splitlines(keepends=False):不同OS换行符不同,该方法能识别所有 Unicode 行边界(\n、\r、\r\n、\v、\f、\u2028 等),常用于跨平台处理文本行,它返回一个列表,执行时如果为splitlines(True)则会保留行尾的换行符,如:
content = "a=1\nb=2\nc=3" config = {} for line in content.splitlines(): if "=" in line: k, v = line.split("=", 1) config[k] = v print(config) # {'a': '1', 'b': '2', 'c': '3'}
替换
- replace('旧串', '新串'[,count=-1]):替换字符串中的指定的旧字符串为新字符串,并返回一个字符串的副本,指定count只替换前count次,默认为-1替换所有旧字符串
- strip(chars=None):返回原字符串移除前导和末尾字符后的副本,如果不指定chars,则默认移除字符串左右两侧的空白字符。chars指定的是一个字符集合,如:'www.example.com'.strip('cmowz.')后变为'example',由此引申出:
- lstrip(chars=None):只移除字符串左侧的指定字符
- rstrip(chars=None):只移除字符串右侧的指定字符
- removeprefix('前缀子串'):如果字符串以指定的前缀开头,则返回移除该前缀后的字符串;如果并不以该前缀开头,则返回原字符串的副本,如:'TestHook'.removeprefix('Test') 返回 'Hook'
- removesuffix('后缀子串'):如果字符串以指定的后缀结尾且不为空,则返回移除该后缀后的字符串;否则则返回原字符串的副本
- translate(table):用于将某些字符转换为另外的字符,如:将'0123456789'替换为'零一二三四五六七八九'中对应的字符,但该方法要求传入的是一个table,它通常由str.maketrans()生成
- str.maketrans():这是一个静态方法,用于返回一个给translate()方法使用的转换对照表(table),主要有以下三种用法:
- 传入字典:t1 = str.maketrans({"a": "A", "b": "Bob","c":None}) "abc".translate(t1) 以实现将a替换为A,b替换为Bob,c替换为空(删除);因此字典中的值可以是一个字符、一个字符串、None(实现删除)
- 传入两个等长字符串,一一对应替换:t2 = str.maketrans("0123456789", "零一二三四五六七八九") print("2024".translate(t2)) #输出二零二四
- 传入三个字符串,一替换二,删除三:如:t3 = str.maketrans("abc", "xyz", "123") print("a1b2c3".translate(t3)) #输出xyz且1、2、3已被删除
大小写转换
- lower():将字符串转换为小写,返回转换后的字符串
- upper():将字符串转换为大写,返回转换后的字符串
- capitalize():首个字符大写,其余为小写,返回转换后的字符串
- title():返回原字符串的标题版本,其中每个单词第一个字母为大写,其余字母为小写,如:'hello world'.title() 转换为 'Hello World'
- swapcase():将原字符串中的小写转为小写,小写转为大写
字符串类型判断:判断整个字符串是否为全字母/数字等,是则返回True,否则返回False
- isalpha():判断是否全为字母(Unicode字母、中文也算字母),如果包含空格、数字等返回False
- isdecimal():判断是否只包含数字(0-9以及少数Unicode十进制数字),带有小数点、正负号、指数、罗马数字(如:IV)都将返回False
- isdigit():判断是否全为数字,指数等上标、下标也视为digit
- isnumeric():判断是否全为数值字符,上标、下标,罗马数字等字符也视为True
- isalnum():是否全是字母或数字,数字包含numeric,因此只有在带有空格、各类符号时才会False
- isidentifier():是否是合法 Python 标识符(变量名)
- islower():是否所有字母都小写,带有的其他符号不影响判断,但如果一个字母没有会返回False
- isupper():是否都是大写,规则同上
- istitle():是否满足标题格式(每词首字母大写),规则同上
- isspace():是否全是空白字符。
- isprintable():是否全可打印,不包含控制字符
格式化
Python中字符串格式化方法很丰富:
- str.center(width,'fillchar'):字符串内容居中,左右两侧填充fillchar指定的字符,返回长度为 width 的字符串。width和fillchar参数都是可选项,默认填充空格,如果指定的width小于len(原字符串),会直接返回原字符串副本。如:'Python'.center(10, '-') 输出 '--Python--'
- str.ljust(width,'fillchar'):字符串左对齐,返回 width 长度的字符串,右侧用指定的fillchar字符填充,参数用法同上,如:'Python'.ljust(10, '.') 输出 'Python....'
- str.ljust(width,'fillchar'):字符串右对齐,右侧填充fillchar字符,返回 width 长度的字符串,用法同上
format方法
str.format()是Python进行字符串格式化的一个非常强大的方法,其语法为:
"字符串".format(*args, **kwargs)
- 允许传入 *args:位置参数;**kwargs:关键字参数,且允许字符串中预留 {} 作为占位符
- 位置参数:format允许按指定的索引填充字符串中预留的位置参数,如果 {} 数量与参数不匹配会报错
"{0} {1}".format("Hello", "World") # 'Hello World' "{1} {0}".format("Hello", "World") # 'World Hello' - 关键字参数:可按关键字填充参数,而无需管参数索引顺序:
"{name} is {age}".format(name="Tom", age=18) # 'Tom is 18' "{age} {name}".format(name="Tom", age=18) # '18 Tom' - 位置参数和关键字参数可以混用,但位置参数必须在前面:
"{a} {}".format("x", a=1) # 合法 "{} {a}".format(a=1, "x") #非法 - 可以访问对象属性或元素
t1={"name":"Tom","lang":"Python"} print("{0[name]} uses {0[lang]}".format(t1)) # Tom uses Python - 占位符中允许使用{[字段名]:[格式说明符]}形式进行格式控制:
"{:>10}".format("hi")     # '        hi'  右对齐
"{:<10}".format("hi")     # 'hi        '  左对齐
"{:^10}".format("hi")     # '    hi    '  居中
"{:*^10}".format("hi")    # '****hi****'  用 * 填充
2.数字格式化
"{:+d}".format(42)        # '+42'    显示符号
"{: d}".format(42)        # ' 42'    正数前加空格
"{:05d}".format(42)       # '00042'  补零
"{:,}".format(1234567)    # '1,234,567'  千分位
"{:.2f}".format(3.14159)  # '3.14'   保留两位小数
"{:.2%}".format(0.1234)   # '12.34%' 百分比
"{:.3e}".format(12345.6)  # '1.235e+04' 科学计数
"{:b}".format(10)         # '1010'   二进制
"{:o}".format(10)         # '12'     八进制
"{:x}".format(255)        # 'ff'     十六进制
"{:#x}".format(255)       # '0xff'   带前缀
3. 复用参数与嵌套字段
如:以变量形式提供输出宽度
"{:{width}}".format("hi", width=6) # 'hi 'f-string
格式化字符串f-string(Python 3.6 引入),使用f或F前缀,用于在字符串中直接嵌入表达式,它在运行时求值,通常比 format() 更快
name = "Tom"
age = 18
f"{name} is {age}"          # 'Tom is 18'
f"{name} is {age + 1}"      # 'Tom is 19'  可放任意表达式
f"{name.upper()}"           # 'TOM'        可调用方法
f"{'yes' if age >= 18 else 'no'}"   # 'yes'
2. 可以使用与 format 相同的格式化语法,如:
x = 3.14159
f"{x:.2f}"          # '3.14'
f"{x:>10.2f}"       # '      3.14'
3.支持多行f-string
msg = (
    f"Name: {name}\n"
    f"Age: {age}"
)
t-string
模板字符串t-string是 Python 3.14 新引入的语法,用t或T前缀,它返回一个 Template 对象而不是普通字符串。Template 对象会保留"静态文本 + 插值"的结构,开发者需要手动拼接这些字符串,适用于防止SQL 注入等安全场景(如 SQL 拼接、HTML 生成、日志脱敏)
name = "Tom"
t1=t"hello,{name}"
print(t1)
# 输出
Template(
    strings=('hello,', ''),
    interpolations=(Interpolation('Tom', 'name', None, ''),))
Template对象包含两部分:
t.strings:静态文本片段
t.interpolations:插值对象
开发者需要手动拼接上述属性中的值
编码
字符与码点
Unicode是一种统一的字符集标准,用于为世界上的各种字符建立统一的编号体系,解决不同国家和语言使用不同字符编码所造成的兼容问题。Unicode 为每个字符分配了一个唯一的码点(code point)(可视为一个整数,占用21位),通常写成U+十六进制数形式 ,如:'A' → U+0041;'中' → U+4E2D。Python 3 使用 Unicode 表示文本,str管理的是 Unicode 码点序列,可以使用以下语句在字符与码点之间转换:
- ord('字符'):获取字符对应的 Unicode 码点,返回 int。如:ord('中') 输出 20013
- chr(码点):根据 Unicode 码点得到对应的字符,返回 str。如:chr(65) 输出 'A'
字符编码
Unicode 为每个字符都提供了独一无二的编号,但网络传输和文件存储并不直接传输/存储完整的 21 位 Unicode 码点,而是通过编码(encoding)将unicode码点转换为字节序列,常见的编码方式有ASCII、UTF-8、UTF-16 等,以常用的 UTF-8 为例。
UTF-8 是变长编码,其特点为:
- 首字节的前缀决定后续跟几个字节(首字节开头有几个 1,就表示总共占几个字节)
- 10 开头是续字节,需要和前面的字节组合使用
- 这样即使从中间某个字节开始读,也能通过前缀识别这是不是字符边界,方便检验
| 码点范围 | 二进制表示 | 字节数 | 内容 |
|---|---|---|---|
| U+0000 ~ U+007F | 0xxxxxxx | 1 | ASCII:英文、数字、标点、控制符 |
| U+0080 ~ U+07FF | 110xxxxx 10xxxxxx | 2 | 阿拉伯字母、希腊字母等 |
| U+0800 ~ U+FFFF | 1110xxxx 10xxxxxx 10xxxxxx | 3 | 中文、日语、韩语等 |
| U+10000 ~ U+10FFFF | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx | 4 | 生僻汉字、emoji、音乐符号等 |
UTF-8编码带来的优势:
- 不需要每个字符都占用21位(为字节对齐需要拓展到24位),能节省网络传输、文件存储所需资源
- 完美兼容ASCII,兼容早期使用ASCII的设备
编码/解码
Python使用以下方法实现从Unicode 字符到字节数据的编码/解码:
- str.encode(encoding="utf-8", errors="strict"):将unicode字符编码为字节数据,该方法返回一个bytes 对象,如:print("你好".encode()) 输出 b'\xe4\xbd\xa0\xe5\xa5\xbd'
- encoding指定编码方式,默认为"utf-8"
- errors指定如何处理编码错误,允许的值有:
- 'ignore':忽略无法编码的字符
- 'replace':用?替换无法编码的字符,输出形式类似于b'??abc'
- 'xmlcharrefreplace':用 XML 字符引用替换
- 'backslashreplace':用 \xNN 转义替换无法编码的字符,输出形式类似于 b'\\u4f60\\u597dabc'
- 任何通过 codecs.register_error() 注册的其他名称
- bytes.decode(encoding='utf-8', errors='strict'):返回解码为 str 的字节串,encoding和errors参数用法同上
其他字符表示
- \ooo可以表示一个八进制字符,如:'\120'表示'P'
- \xhh(必须两位)可以表示一个十六进制字符,如:'\x50'表示'P'
- \N{name} 表示具有给定 name 的Unicode字符,如:'\N{SNAKE}'表示'🐍'
- \uxxxx(\u需要4位)和\Uxxxxxxxx(\U需要8位)表示具有给定十六进制值的Unicode字符
bytes
bytes是一种不可变的字节序列类型,序列中的每个元素都是 0~255 的整数(一个字节),用于表示二进制数据,包括:
- 文本经过某种编码后的字节(UTF-8等)
- 图片、音频、视频的原始数据
- 网络协议数据包
- 加密/压缩后的数据
- 序列化后的对象
创建bytes
- 通过构造器bytes( source )创建
- 可传入一个整数n,创建一个 n 字节值全 0 的字节串:如:bytes(5) 创建出b'\x00\x00\x00\x00\x00';如果不传入参数,则创建一个空字节串,长度为0,如:b1 = bytes(),b1指向一个bytes对象,该对象中存储的值为b''
- 传入一个可迭代对象,这些对象的每个元素必须是0-255的整数:如:bytes([65, 66, 67])值为b'ABC';bytes(range(3))值为b'\x00\x01\x02'
- 传入字符串,必须指定编码方式:如:bytes('abc')报错without an encoding,必须bytes('abc', 'utf-8');bytes('abc', 'utf-8', 'strict'),关于编码的参数参考 str编码
- 实际上,构造器通过尝试调用对象的 bytes 方法,或者走 buffer 协议来创建bytes
- 通过字面量:以b'xxx'形式
- 这里字符串中的直接字符只接收ASCII字符,如:b"hello"是允许的,b'你好'是非法的
- 非ASCII码需要经过编码,以转义序列方式给出,如:b'\xe4\xbd\xa0\xe5\xa5\xbd'(代表utf-8下的你好)
- 其他一些方式也会返回/创建bytes,如:以二进制模式读文件,with open('a.bin', 'rb') as f: data = f.read()将返回bytes
bytes与str
字符串可以通过字面量(ASCII字符)或字符串编码(非ASCII字符,通过 str.encode()方法 )形式快速转为bytes,方便网络传输、文件存储等,参考 str编码/解码
b1 = b'abcd'
print(b1[0]) # 97
print(ord('a')) # 97
对于中文,一个中文在utf-8编码下,占用3字节,单个字节的数据是没意义的,需要对应字节数的数据
b2 = "你好".encode()
print(b2) # b'\xe4\xbd\xa0\xe5\xa5\xbd'
print(b2[0:3].decode()) #'你'
print(' '.join(str(x) for x in b2)) #转为十进制'228 189 160 229 165 189'
bytearray
bytes 是不可变字节序列,不支持对原数据的修改,由此Python还提供了 bytearray,它是可变字节序列,属性与接口与 bytes 很相近,但它支持原地修改,支持可变序列的一系列操作
创建bytearray
bytearray中的每个元素也是 0~255 的整数,构造方法与 bytes 几乎相同:bytearray( source )
- 可传入整数、可迭代对象、字符串,如:bytearray([65, 66, 67])输出bytearray(b'ABC')
- 可以直接将 bytes 改造成 bytearray:bytearray(b'abc')
ba = bytearray(b'abc')
ba.append(100) # 追加一个字节,bytearray(b'abcd')
ba.extend(b'ef') # 追加多个字节,bytearray(b'abcdef')
ba.insert(0, 65) # 在位置 0 插入一个int,打印后为bytearray(b'Aabcdef')
ba.remove(65) # 根据值删除字节
ba.pop(0)     # 根据位置弹出字节
ba.reverse() # 原地反转
memoryview
memoryview是 Python 提供的二进制数据视图类型,用于让程序直接访问处理其他对象所提供的底层内存缓冲区,而不必复制其中的数据。它实现的是对支持缓冲区协议(Buffer Protocol)对象的"零拷贝"视图,并暴露访问接口,因此创建 memoryview 通常不会复制原对象中的数据。它常用于:
- 零拷贝(Zero-copy)处理大数据:在处理大文件、网络数据包、图像/音频缓冲区时,不会像切片 bytes、bytearray 一样创建新对象并复制数据,能显著节省内存和 CPU
- 高效解析网络包、文件头、二进制格式
创建memoryview
使用构造器memoryview( )创建,创建时如果底层对象是只读的,例如 bytes,则创建出来的 memoryview 也是只读的,因为它们本质上是同一块缓冲区
属性
- mv.obj:底层原对象
- mv.nbytes:总字节数
- mv.itemsize:单个元素字节大小
- mv.ndim:维度数
- mv.shape:各维度大小(元组)
- mv.strides:各维度步长(元组)
- mv.format:元素格式(如 'B'、'i')
- mv.readonly:是否只读(bool)
- mv.contiguous:是否连续内存
- mv.c_contiguous / mv.f_contiguous:C / Fortran 连续
操作
- 支持索引、切片:且如果数据不是readonly,可以通过该方式赋值,如:mv = memoryview(b'hello');mv[0] # 104
- mv.release():释放缓冲区
- mv.toreadonly()返回只读视图
- mv.cast():指定数据的解释方式,具体参考文档
将数据复制独立出来 - mv.tobytes():将数据复制为bytes,如:data = bytearray(b'abcdef');view = memoryview(data);b = view.tobytes(),此时 b 是独立的 bytes 对象,与原缓冲区不再共享数据
- mv.tolist()::将数据复制为list
with open('big.bin', 'rb') as f:
    data = f.read()
mv = memoryview(data)
header = mv[:16]
body = mv[16:]
集合
集合(set)是一种用于存放不重复、无序元素的容器类型。常用于去除重复元素、判断元素是否存在、进行并集、交集、差集、对称差集等运算。集合中的元素必须是可哈希(hashable)的,因此不能直接包含 list、dict、set(嵌套另一个集合)等不可哈希对象。Python 提供两种集合类型:
- set:可变集合,如:{1,2,3}
- frozenset:不可变集合,如:frozenset({1, 2, 3})
特点
集合有以下鲜明的特点,并决定了它的操作:
- 元素无序:集合不按照元素加入的顺序保存元素,因此操作不能依赖元素的排列顺序,由此不支持索引、切片操作。要在保证元素出现顺序的情况下去重,参考 字典的dict.fromkeys( iterable )方法
- 元素不重复:集合中的同一个元素只能出现一次,因此常用于去重:list(set([1, 2, 2, 3, 3]))去重后为 [1, 2, 3]
- 元素必须可哈希:集合内部元素必须是可哈希对象,因此集合元素可以是int、str、tuple、frozenset等本身不可变的类型,如:{1, "abc", (1, 2)},但不能是list、普通set、dict,如:不能是 {[1, 2]}、{"a": 1}、{{1, 2}}
集合的底层实现
集合的无序、元素不重复、元素需要可哈希来源于它的底层实现,这里对比list进行介绍
集合操作
- in/not in:判断某项是否存在于集合中,如:x in s,如果s中的某项等于x则结果为True,否则为 False,x not in s 反之
- len(s):返回集合中的元素数量
- 支持迭代:但迭代顺序不应作为程序逻辑依据,两次执行相同代码可能因为集合扩容导致元素顺序变更,程序有不同结果
判断集合关系 - a <= b:a 是 b 的子集则返回True,等价于 a.issubset(b)
- a < b:a 是 b 的真子集则返回True
- a >= b:a 是 b 的超集则返回True,等价于a.issuperset(b)
- a > b:a 是 b 的真超集则返回True
- a == b:检查两个集合元素是否相同,结果只取决于元素是否相同,与元素排列无关,a != b 类似
- a.isdisjoint(b):若两个集合并无交集,则返回True
以下操作会创建新集合 - 并集 a | b 或 a.union(b):两个集合中所有元素组成的新集合
- 交集 a & b 或 a.intersection(b):两个集合共同拥有的元素组成一个集合
- 差集a - b 或 a.difference(b):出现在第一个集合、但不出现在第二个集合中的元素,a - b 和 b - a 结果通常不一样
- 对称差集a ^ b 或 a.symmetric_difference(b):只出现在其中一个集合、但不同时出现在两个集合中的元素,如:{1, 2, 3} ^ {2, 3, 4} = {1, 4}
可变集合 set
创建 set
- 使用构造器set( iterable ),如:set([1,2,3]),当然元素不能是可变的,如:set([1,2,[3]])中[3]是list,非法元素
- 集合字面量使用{ }包裹,如:s={1,2,3},空集合必须用构造器set()构造,{ }创建的是空字典
可变集合的操作
set 是可变类型,因此除了集合的公共运算外,还提供修改自身的方法
- s.add(x):添加元素x,如果x已经存在,不会产生重复元素
- s.remove(x):删除指定元素,如果元素不存在,会抛出 KeyError
- s.discard(x):删除指定元素,不存在也不会报错
- s.pop():随机弹出一个元素,由于集合无序,不应该假定 pop() 返回哪个元素
集合还支持以下原地修改 - 并集a |= b 或 a.update(b):原地修改a为二者并集
- 交集a &= b 或 a.intersection_update(b):原地修改a为二者交集
- 差集a -= b 或 a.difference_update(b):原地修改a为二者差集
- 对称差集a ^= b 或 a.symmetric_difference_update(b):原地修改a为二者对称差集
冻结集合frozenset
frozenset 是不可变集合类型,它与 set 一样保存不重复元素,但创建后不能增加、删除或修改元素。
由于 set 是可变的,因此它不能作为 set 的元素、dict的键,但 frozenset 可以,因此frozenset的最大作用就是替代 set 完成上述任务。
创建frozenset
使用构造器frozenset(iterable),如:从set接收 frozenset({1, 2, 3}) 或创建空的冻结集合frozenset()
映射类型
映射(mapping)是一类通过可哈希对象作为键(key)映射到任意对象作为值(value)的数据类型。映射类型是可变对象,可以根据键查找、添加、修改和删除对应的值。Python 标准库目前提供的标准映射类型是字典(dict),此外 collections 模块还提供了 dict 的变种,如 defaultdict 和 OrderedDict,它们在 dict 的基础上针对特定使用场景提供了不同的行为
字典dict
字典(dict)是一种可变的映射(mapping)类型,用于存储键值对(key-value pair)数据,在有的语言中被称为map,能通过键可以快速找到对应的值,具有极快的查找速度。字典:user = { "name": "Tom", "age": 20, "city": "Beijing" }
字典的特点
- 可变(mutable):可以增、删、改键值对
- 保存键值对(key-value pair):数据以 key: value 形式成对出现
- 通过键访问值,而不是通过位置访问
- 键必须是可哈希对象且键不能重复,支持作为键的类型有如:1、3.14、"abc"、(1, 2),不可作为键的类型有:列表 [1, 2]、集合{1, 2}、字典{"a": 1}
- 如果向字典中加入已经存在的键,不会产生新的元素,而是修改该键对应的值
- 值可以重复,也可以是任意类型
- 查询高效:基于哈希表实现,查找平均时间复杂度 O(1)
- 有序性:Python 3.7+以后开始,字典保持插入顺序
字典的底层实现
类似于集合set,字典在Python中也是通过散列表实现的
- 字典底层使用哈希表保存键值对,其基本实现思想与集合(set)类似。插入或查找元素时,Python 首先对键调用 hash() 计算哈希值,再根据哈希值确定其在哈希表中的候选位置,因此字典根据键进行查找、插入和删除的平均时间复杂度通常为 O(1)
- 根据键查找值时,Python 首先调用 hash(search_key) 计算键的哈希值,并取哈希值的最低几位作为偏移量,在哈希表中定位对应的表元(slot)
- 如果表元为空,说明字典中不存在该键,返回异常或空
- 如果表元不为空,则比较其中保存的 key 与 search_key 是否相等。如果相等,则找到对应的值
- 如果两者不相等,说明发生了哈希冲突,算法需要从哈希值中另取几位进行处理,利用新得到的偏移值查找表元,并重复上述步骤,直到找到目标键或确定该键不存在(这种冲突很少,百万个元素的dic,每次搜索平均下来才有一两次冲突)
- 插入新的键值对时,Python 会根据哈希表的拥挤程度决定是否扩容。扩容后需要重新组织表中的元素,使哈希表保持较低的装载程度,从而减少哈希冲突和探测次数,维持字典查找、插入和删除操作接近 O(1) 的平均时间复杂度
创建字典
- 通过构造器dict( ),如:d = dict(name="Tom", age=20);d = dict([("a", 1), ("b", 2)])
- 使用{ }创建字面量,如:空字典d = {}
- 字典推导式,如:d = {x: x * x for x in range(10) if x % 2 == 0}
- 通过zip()将两个序列组合成键和值,再转换为字典:keys = ["name", "age"] values = ["Tom", 20] d = dict(zip(keys, values))
字典操作
- 以下方法中,d 指代已经声明好的字典对象
- in/not in:判断键是否存在于字典,判断值是否存在可以使用:"值" in d.values()
- len(d):返回的是字典中键值对的数量
- d["键"]:访问该键的值,如果键不存在,会抛出 KeyError
- d.get("键"[,默认值]):安全地获取键对应的值,如果指定键不存在则返回None,如果还指定了默认值则返回该默认值
- d["键"]=:添加/修改键值,如果该键不存在,则添加,如果存在则修改
- del d["键"]:删除指定键,如果键不存在,会产生 KeyError
- d.pop("键"):删除指定键,并返回被删除的值,如果指定键不存在,产生 KeyError。可以写为d.pop("键",默认值)形式,如果指定键不存在,则返回默认值,如:d.pop("x", None)
- d.popitem():删除并返回最后插入的键值对
- d.clear():清空字典,字典对象本身仍然存在,只是变为空字典
- dict.fromkeys( iterable ):类方法,从可迭代对象获得 key ,该方法常用来在保证元素出现顺序不变的情况下去重(set不保证元素出现顺序),它利用字典键的唯一性去重,如:lst = [1, 2, 3, 2, 4, 1, 5] result = list(dict.fromkeys(lst))
以下操作返回的是字典视图对象(view),以 d ={'a': 1, 'b': 2} 为例 - d.keys():返回字典中所有键的动态视图, 如:d.keys() 返回 dict_keys(['a', 'b']),默认情况下遍历字典返回的就是键,因此遍历键可以直接 for key in d 而不需要 for key in d.keys()
- d.values() :返回字典中的所有值,如:d.values() 返回 dict_values([1, 2]),常用于遍历值:for value in d.values()
- d.items():返回所有键值对,如:返回 dict_items([('a', 1), ('b', 2)]),常用于同时遍历键、值,如:for key, value in d.items()
- 字典视图对象可以被显示转换为列表等:如:list(d.keys())、list(d.values())、list(d.items())
字典更新
- d.update():用另一个映射或键值对序列更新当前字典,由于是原地更新,返回值为None,如:d = {"a": 1, "b": 2}进行更新 d.update({"b": 20, "c": 3}),已有键会被覆盖,新键会被添加
- d.setdefault(key, default):如果键存在,返回原来的值;如果键不存在,则将该键值对添加到字典,并返回值,d = {"a": 1};d.setdefault("a", 100) #返回1 d.setdefault("b", 200) # 返回200,最后d = {"a": 1, "b": 200}
- a | b:合并两个字典,如果存在相同键,右侧字典的值覆盖左侧字典,因此 a |= b 可以原地更新a
表达式
标识符
NAME规则用于标识符、关键字 和软关键字,它们由以下字符组成:
- 大写字母A-Z和小写字母a-z
- 下划线 _
- 数字0-9,但不能作为第一个字符
- 部分非ASCII字符,如:Unicode字符(包括一些表情)、中文字符等
- 必须至少包含一个字符,但没有长度上限,大小写敏感
- 定义变量,不需要let、int等关键字,如:num=10 即可,在Python shell再次输入该变量,会输出该变量的值
命名习惯
- 常量通常用全大写表示
- 普通变量、函数、模块使用下划线命名,而不是小驼峰,如:user_name
- 类名使用大驼峰,如:class UserAccount
- 私有/内部变量前面加一个下划线,如:_local_state = None,表示“这是内部使用的,不建议外部直接访问”,但 Python 不会强制阻止访问
- 避免命名冲突,可以在变量名后添加一个下划线,如:id_ = 123
- 魔术方法使用双下划线包围,如:__init__
数值运算
- 运算符:+-*/=%(四则运算,赋值,取余),**(乘方),//(向下取整除法),**优先级比-高,比如:-3**2会被解析为-(3**2)
- python中的数值是不可变类型,因此python不支持 i++ 、i--这类原地修改 i 的运算,只能重新赋值(重新绑定name):i+=1、i-=1
- 矩阵乘法运算符:@,如:a @ b,但是Python 内置数值类型没有实现 @,通常由 NumPy 等第三方类型实现
- 多个表达式用,号分隔,返回的结果是元组,如:x=10 y=20 执行 x+y,x*y,x/y 由于逗号的关系,返回结果是个元组 (30, 200, 0.5)
位运算
- 移位运算符:<<(左移),>>(右移)
- 位运算符:&(AND),^(XOR),|(OR)
- 按位取反:~
比较运算
- 比较运算符:<、>、<=、>=、==、 !=
- Python中的比较运算可以连续书写,如:a < b < c等价于 a < b and b < c,但 b 只求值一次
身份比较与成员测试
- is/is not:判断两个名称是否指向同一个对象,如:a is b,它与 == 不同,a == b是判断值是否相等
- in / not in:判断元素是否属于某个容器,具体判断方式由对象类型决定,也可以通过 __contains__() 自定义
逻辑运算
- and:与运算,如:x and y
- or:或运算,如:True or True
- not:非运算,如:not True
- and和or是短路运算符
- Python 的 and、or 不一定返回 True / False,而是返回实际参与运算的对象,如:x and y,如果 x 为假,直接返回 x;如果x 为真,计算并返回 y。因此可用name = user_name or "unknown"提供默认值
条件表达式(三元运算符)
值1 if 条件 else 值2:又称三元运算符,用于根据条件产生不同的值,条件为真,计算并返回值1,否则返回值1,如:print("yes" if flag else "no")
海象运算符
变量 := 表达式:用于给变量赋值的同时,返回被赋的值
if (n := len(data)) > 10:
    print(n)
解包
解包(Unpacking)是一种将可迭代对象(如列表、元组、字符串等)中的元素拆分并赋值给多个变量的语法(特性类似于JS中的解构赋值,但有区别),Python中的解包可以通过以下方式:
- 通过相同数量的变量-元素解包:如:a, b, c = (1, 2, 3),变量 a,b,c 都将获得对应的值,该方法可以直接交换变量而不需要中间变量,如:a,b=1,2 #定义变量时解包 a,b=b,a #交换变量时解包
- 通过*号收集多余元素,可以放在任意位置,多余的元素会被打包到一个列表里(即使只有一个元素),但一个表达式中只能用一次
1.接收多个元素
a, *b = [1, 2, 3, 4]
print(a)  # 1
print(b)  # [2, 3, 4]
2.*可以位于任意位置
first, \*middle, last = (1, 2, 3, 4, 5)
print(first)   # 1
print(middle)  # 存入[2, 3, 4]
print(last)    # 5
3.可用于连续展开元素,如果是用于展开迭代对象的元素,可用多个*
a = [1, 2]
b = [3, 4]
[*a, *b] # 展开为 [1, 2, 3, 4]
[a,b]    # 会展开为 [[1, 2], [3, 4]]
- 通过_或*_收集不关心的值
a,_,b,_=(10,20,30,40)
print(a)  # 10
print(b)  # 30
- *用于解包普通可迭代对象,**则用于解包映射对象(Python中通常是字典)
1.构造字典
a = {"x": 1}
b = {"y": 2}
{**a, **b} #构造出{'x': 1, 'y': 2}
2.用于函数传参时解析字典
def add(a, b, c):
     return a + b + c
params = {'a': 1, 'b': 2, 'c': 3}
print(add(**params))  #解析字典 6
推导式
列表/集合/字典推导式
推导式(comprehension)用于根据一个可迭代对象快速构造新的列表、集合或字典。列表、集合、字典推导式的基本结构几乎相同,区别主要在于最终生成元素的形式以及使用的括号,以列表推导式为例,表达式格式为:
[ 元素生成表达式 for语句 [ if语句 for语句 if语句.... ]]
- 集合/字典推导式只需要相应地修改括号和表元素生成表达式
- for 语句可提供多个,以形成嵌套的 for 循环语句
- 可通过if语句执行判断
- 每次求的元素只能为一个/一组整体,不允许 [x,y for ......] 但可以 [(x,y) for ......],其中(x,y)为一个元组
1.简单的列表/集合/字典推导式
[x**2 for x in range(5)] #列表推导式 [0, 1, 4, 9, 16]
{x % 3 for x in range(10)} #集合推导式 {0, 1, 2}
{k: len(k) for k in ["cat", "python", "OS"]} #字典推导式 {'cat': 3, 'python': 6, 'OS': 2}

2. 可以有多个for
[f"{x}--{y}" for x in range(3) for y in range(2)]
返回 ['0--0', '0--1', '1--0', '1--1', '2--0', '2--1']
它的本质是 for 循环嵌套:
result = []
for x in range(3):
    for y in range(2):
        print(f"{x}--{y}")

3.可以用if语句过滤数据
[f"{x}--{y}" for x in range(4) if x%2==0 for y in range(4) if y%2==1]
x只要偶数,y只要奇数
输出 ['0--1', '0--3', '2--1', '2--3']

4.如果要用if..else..条件表达式选择数据,则应当写在元素生成表达式中
[x if x%2==0 else x*100 for x in range(5)]
输出 [0, 100, 2, 300, 4]

5. 两个数据需要从不同的迭代对象获取
name = "Jay Tom Blues Ken"
scores = (60, 65, 71, 68)
利用zip()拼接数据源
{name:score for name,score in zip(name.split(" "),scores)}
输出 {'Jay': 60, 'Tom': 65, 'Blues': 71, 'Ken': 68}

6.推导式不允许一次生成多个元素,因此通常将多个元素组成一个元组一起获得
[(x,y) for x,y in zip([1,2,3,4],[11,22,33,44])]
获得 [(1, 11), (2, 22), (3, 33), (4, 44)]
若要继续拆解元素,可用第2个for处理前一个for的结果
[v for x,y in zip([1,2,3,4],[11,22,33,44]) for v in (x,y)]
输出 [1, 11, 2, 22, 3, 33, 4, 44]
语义更清晰的写法是不使用列表推导式:
 result=[]
for x,y in zip([1,2,3,4],[11,22,33,44]):
    result.extend((x,y))
生成器表达式
生成器表达式(generator expression)与列表推导式语法基本相同,但不会立即生成完整列表,而是产生一个生成器,用于根据可迭代对象逐个产生数据。语法与列表推导式基本相同,但外层使用()包裹,并且有以下特点:
- 返回一个生成器对象(generator object),可以用循环语句、next()逐个获取元素
- 采取惰性求值,列表推导式立即计算并创建列表,生成器表达式则保存生成规则,在迭代时逐个计算,因此它适合处理大量数据而不是一次性生成数据的场景,可以减少内存占用
- 生成器表达式本身只能产生一次数据,如:g = (x for x in range(3)) 首次获取生成器对象 list(g) #[0, 1, 2],再次获取list(g) 给出 []
- 语法和推导式类似
语法练习题
- 给定 n=-17,使用 // 和 % 计算 n//5、n%5,并解释为什么结果如此。
- 给定 s="hello",统计字符串长度,并分别取得第一个、最后一个和倒数第三个字符。
- 给定 s="Python Programming",使用索引和切片取得 "Python"、"Programming"、"Pyth" 和逆序字符串。
- 给定 s=" Hello, Python! ",去除两端空白,并将结果转换为大写、小写和首字母大写形式。
- 给定 s="apple,banana,orange,pear",按逗号分割成 list,再使用 join() 恢复成字符串。
- 给定 s="hello world",判断其中是否包含 "world",并统计字符 "l" 出现次数。
- 给定 s="a-b-c-d",使用 split() 得到列表,再将列表元素用 ":" 连接。
- 给定 s="Python123",判断它是否只包含字母、只包含数字、是否以 "Py" 开头、是否以 "123" 结尾。
- 创建 list=[10,20,30,40,50],完成索引访问、负索引访问、切片、逆序和步长为 2 的切片。
- 给定 list=[1,2,3],分别使用 append()、extend()、insert() 添加元素,并观察三者区别。
- 给定 list=[1,2,3,2,4,2],统计 2 的出现次数,找到第一个 4 的位置,并删除一个 2。
- 给定 list=[5,3,8,1,9,2],分别使用 sorted() 和 list.sort() 排序,并比较返回值。
- 给定 list=[1,2,3,4,5],使用切片完成:删除前两个元素、删除最后一个元素、在中间插入多个元素。
- 给定 list=["a","b","c"],使用 enumerate() 得到元素及其索引。
- 给定 list=[1,2,3],将其转换为 tuple,再将 tuple 转回 list。
- 创建 tuple=(10,20,30,40),完成索引、切片、解包和成员判断。
- 给定 tuple=(1,2,2,3,2),统计 2 的数量并找到第一个 3 的索引。
- 创建 tuple=(1,[2,3],4),修改其中 list 的内容,并观察 tuple 本身是否可以包含可变对象。
- 创建 dict={"name":"Tom","age":20,"score":95},分别通过键访问、修改、新增和删除元素。
- 给定 dict={"a":1,"b":2,"c":3},分别使用 keys()、values()、items() 遍历字典。
- 给定 dict={"apple":3,"banana":5},判断 "apple" 和 "orange" 是否为键。
- 给定 dict={"a":1,"b":2},尝试访问不存在的键,分别使用 [] 和 get(),观察区别。
- 创建两个字典 {"a":1,"b":2} 和 {"b":3,"c":4},使用 | 合并它们,并观察重复键的结果。
- 给定 dict={"name":"Alice","scores":[80,90,95]},访问嵌套 list,并将 90 修改为 100。
- 创建 set={1,2,3,4},完成添加、删除、成员判断,并观察重复元素的行为。
- 给定两个集合 A={1,2,3,4}、B={3,4,5,6},分别计算并集、交集、差集和对称差集。
- 给定 list=[1,2,2,3,3,3,4],转换成 set 去除重复元素,再转换回 list。
- 比较 list、tuple、set 在成员判断、索引访问和重复元素方面的区别。
- 创建 bytes=b"Python",完成索引、切片、len() 和成员判断。
- 给定 b"hello",分别取得第一个字节和前两个字节,观察索引与切片返回的类型是否相同。
- 给定字符串 s="你好,Python",使用 UTF-8 编码转换为 bytes,再使用 decode() 恢复为 str。
- 给定 b"Python + 14",解码为字符串后替换其中的版本号,再重新编码为 bytes。
- 给定数字列表 [65,66,67,68],转换为 bytes,并观察结果;再将 bytes 转换为 list。
- 给定 bytes 数据 b"12345",将其转换为 list、str,并比较直接 str(b) 与 b.decode() 的区别。
- 给定字符串 "hello",分别转换成 list、tuple、set,观察三种结果的结构差异。
- 给定 list=["1","2","3","4"],将每个元素转换为整数,得到 [1,2,3,4]。
- 给定 list=[1,2,3,4],将每个整数转换为字符串,得到 ["1","2","3","4"],再使用 join() 拼接。
- 给定 tuple=("a","b","c"),转换为字符串 "abc",再转换回字符列表。
- 给定字符串 "abcabc",转换为 set,观察结果;再将 set 转换为 list 并排序。
- 给定 list=[("name","Alice"),("age",20),("score",95)],将其转换为 dict。
- 给定 dict={"a":1,"b":2,"c":3},转换 keys()、values()、items() 为 list 和 tuple。
- 给定 dict={"a":1,"b":2,"c":3},把所有键转换为 list,把所有值转换为 set。
- 给定两个 list:[1,2,3,4] 和 [3,4,5,6],分别使用集合运算求共同元素、只存在于第一个列表的元素和所有不重复元素。
- 给定字符串 "red,green,blue",转换为 list、tuple、set,并分别恢复成字符串。
- 给定整数 123456,转换成字符串后反转,再转换回整数,得到 654321。
- 给定 bytes=b"hello",先转换成 list,再修改其中一个字节,最后重新转换成 bytes。
- 给定 bytearray(b"hello"),修改其中一个字节,再转换成 bytes 和 str。
- 给定 frozenset([1,2,3]),进行成员判断、集合运算,并尝试修改它。
- 创建一个包含 list、tuple、set、dict、bytes 的混合列表,分别访问其中元素并判断各元素类型。
- 给定 data={"name":"Alice","tags":["python","linux"],"ports":{80,443}},分别访问和修改嵌套的 list、set 元素。
- 给定用户输入形式的字符串 "Alice,20,Python",将其拆分后转换成包含 name、age、language 的 dict。
- 给定字符串 "1,2,3,4,5",转换成整数列表,再计算总和、最大值、最小值和平均值。
- 给定字符串 "apple banana apple orange banana apple",统计每个单词出现次数,结果保存为 dict。
- 给定 list=[1,2,3,2,4,1,5],在保持原始出现顺序的前提下去除重复元素。
- 给定 bytes=b"\x48\x65\x6c\x6c\x6f",解码或转换它,得到 "Hello"。
- 综合题:给定字符串 "Python,Python,Java,C,Python,Go",统计每种语言出现次数,并保存为字典,并得到不重复语言集合、按出现顺序去重后的列表以及按字母排序后的列表。
s = "Python,Python,Java,C,Python,Go"
1.统计次数与去重集合
\# 字典推导
result = {word: s.split(",").count(word) for word in s.split(",")}
\# 性能更高:先用set去重
words = s.split(",")
result = {word: words.count(word) for word in set(words)}
\# 开发推荐,collections.Counter
from collections import Counter
result = dict(Counter(s.split(",")))
2. 按出现顺序去重后的列表
d = dict.fromkeys(s.split(","))
l = list(d)
3.按字母排序
l.sort()